Le pagine dedicate alle liberatorie dei modelli tendono a pubblicizzare punteggi di allucinazione bassissimi, inferiori all'1% nei test di accuratezza standard. Questi numeri sono reali. Tuttavia, sono pressoché irrilevanti per gli ambiti in cui le allucinazioni contano di più. Questo articolo mette a confronto i dati di riferimento, accuratamente elaborati, con i dati sperimentali ottenuti in contesti legali, medici e aziendali, e mostra perché il divario tra di essi rappresenta uno dei problemi meno discussi nell'ambito dell'intelligenza artificiale al momento.
Che cos'è un'allucinazione da intelligenza artificiale?
Un'allucinazione si verifica quando un modello di intelligenza artificiale afferma qualcosa con sicurezza e fluidità che è fattualmente errato o completamente inventato: un finto caso giudiziario, una statistica falsificata, un'affermazione medica priva di fondamento, una citazione inesistente. Il pericolo non sta nel fatto che l'IA sbagli, ma nel fatto che una risposta frutto di un'allucinazione appare solitamente altrettanto impeccabile e sicura di una risposta corretta, il che la rende difficile da individuare senza una verifica.
I numeri di riferimento: cosa viene pubblicizzato?
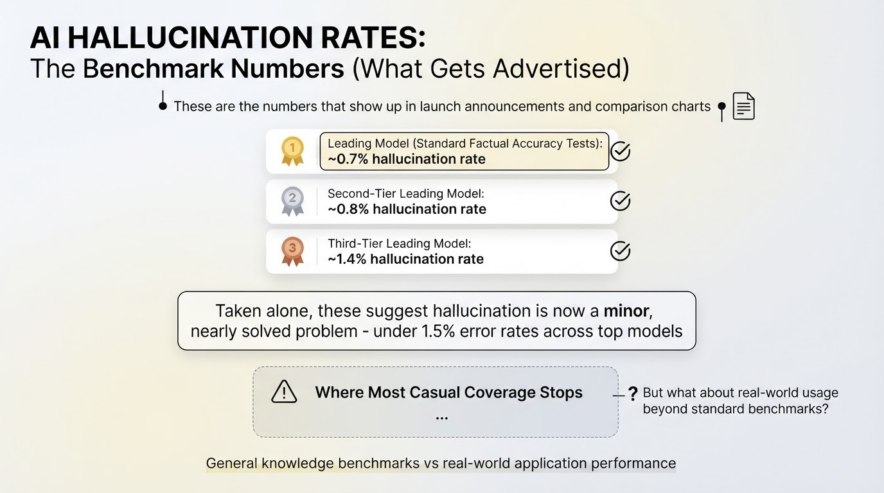
Modello (Benchmark di conoscenze generali) | Tasso di allucinazioni |
Modello di riferimento per i test standard di accuratezza fattuale | ~ 0.7% |
Modello leader di secondo livello | ~ 0.8% |
Modello leader di terzo livello | ~ 1.4% |
Questi sono i numeri che compaiono negli annunci di lancio e nei grafici comparativi. Presi singolarmente, suggeriscono che le allucinazioni siano ormai un problema minore, quasi risolto, con tassi di errore inferiori all'1.5% tra i modelli di punta. È qui che la maggior parte delle analisi superficiali sull'argomento si ferma.
I numeri reali: cosa succede in ambiti specifici
Domini | Tasso di allucinazioni | Fonte / Contesto |
Indice di conoscenza generale (dato di marketing) | 0.7-1.4% | Test standardizzati di accuratezza fattuale |
Intelligenza artificiale in ambito legale, compiti specifici del settore (media) | ~ 6.4% | Media del settore per i casi di utilizzo legale |
Intelligenza artificiale in ambito legale, quesiti legali specifici (ricerca di Stanford) | 58-88% | Testare i principali modelli su quesiti reali di ricerca giuridica. |
Intelligenza artificiale in ambito medico, compiti specifici del settore (media) | 10-20% | Media del settore per casi di utilizzo in ambito medico. |
Intelligenza artificiale in ambito medico, test rapidi dipendenti dalla qualità | 43-64% | A seconda di come è stata formulata la domanda |
Il divario qui è enorme: non una piccola differenza, ma una differenza misurata in decine di volte. Un modello che ha allucinazioni in meno dell'1% dei casi su un benchmark di cultura generale può avere allucinazioni in più della metà dei casi di quesiti reali di ricerca legale. Questo è il dato che praticamente non compare mai nella stessa frase del benchmark di marketing, sebbene entrambi descrivano gli stessi modelli sottostanti.
Perché il divario è così ampio?
Diversi fattori spiegano perché i tassi di allucinazioni specifiche di un determinato ambito siano molto più elevati rispetto a quanto suggerito dai parametri di riferimento generali:
I benchmark generali verificano fatti semplici e ben documentati — capitali, scienza di base, conoscenze comuni che compaiono costantemente e in modo coerente nei dati di addestramento di un modello
Le questioni legali e mediche richiedono informazioni precise, specifiche e spesso difficili da reperire. — una citazione di un caso specifico, una specifica interazione farmacologica, uno specifico dettaglio normativo — dove essere "vicini" alla correttezza equivale, dal punto di vista funzionale, ad essere sbagliati.
Le modelle vengono addestrate a sembrare sicure di sé a prescindere dalla loro effettiva certezza. — non esiste alcun meccanismo integrato che costringa un modello a dire "Non lo so" invece di generare una risposta che sembri plausibile ma sia inventata.
I domini specializzati hanno meno dati di addestramento ripetuti e ridondanti — un modello vede molte descrizioni di fatti comuni e pochissime descrizioni di singoli casi legali oscuri, il che rende più facile per il modello mescolare o inventare dettagli
Il costo aziendale
Le allucinazioni non sono solo una statistica di accuratezza: comportano un costo finanziario misurabile che aumenta con la diffusione di questo fenomeno.
Metrico | figura |
Costo stimato a livello globale delle allucinazioni causate dall'intelligenza artificiale per le imprese, 2024 | $67.4 miliardi |
Costo previsto, 2025 | $112 miliardi |
Trend | Crescere di pari passo con l'adozione, non diminuire. |
Questo è un caso in cui una maggiore diffusione sta aumentando il costo complessivo del problema, anche se la precisione dei singoli modelli migliora lentamente: un numero maggiore di persone che si affidano ai risultati dell'IA per prendere decisioni importanti significa maggiori possibilità che un'allucinazione non rilevata causi danni reali.
Cosa riduce effettivamente le allucinazioni (e cosa no)
Questa è la parte dei dati che è realmente utile per chiunque implementi l'intelligenza artificiale in un flusso di lavoro reale.
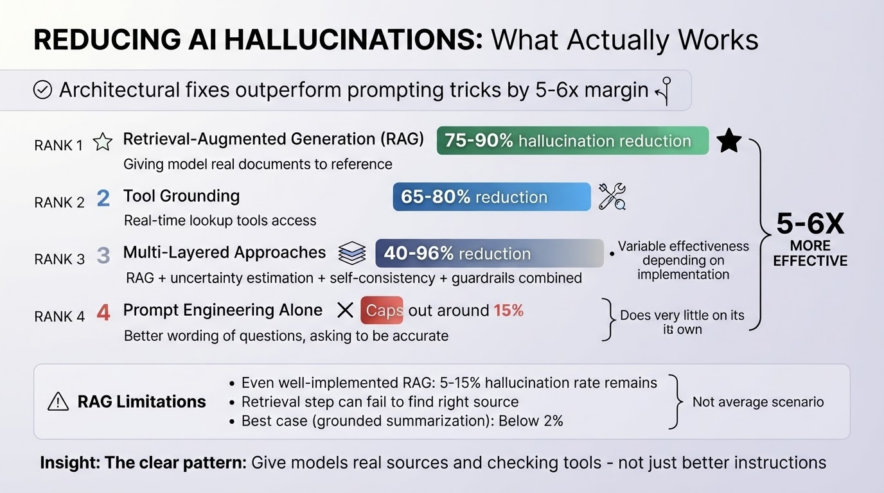
Tecniche classificate in base all'efficacia:
Tecnica | Riduzione delle allucinazioni |
Generazione aumentata di recupero (RAG) | 75-90% |
Ancoraggio degli strumenti (consentire al modello l'accesso a strumenti di ricerca in tempo reale) | 65-80% |
Approcci multistrato (RAG + stima dell'incertezza + autoconsistenza + meccanismi di controllo combinati) | 40-96% |
Ingegneria rapida da sola (formulazione migliore della domanda) | Limite massimo intorno al 15% |
Lo schema è chiaro: le correzioni architettoniche, ovvero fornire al modello documenti reali di riferimento e strumenti per verificarne il funzionamento, sono di gran lunga più efficaci dei semplici suggerimenti, risultando circa cinque o sei volte più efficaci. Chiedere al modello di essere più preciso o di "essere accurato" non sortisce alcun effetto significativo.
Dove RAG presenta ancora delle lacune:
Anche i sistemi RAG ben implementati producono ancora allucinazioni nel 5-15% dei casi, di solito quando la fase di recupero stessa non riesce a trovare il documento di origine corretto. Le attività di riassunto basate su dati concreti possono ridurre il tasso di allucinazioni al di sotto del 2%, ma questo è lo scenario migliore, non la media.
Come le aziende individuano effettivamente questi errori
Metodo di rilevamento/mitigazione | Adozione aziendale |
RAG come mitigazione automatizzata | 68% delle imprese |
Processi di revisione con intervento umano | 76% delle imprese |
API di verifica dedicate | Solo il 19% delle imprese |
Sistemi di rilevamento in tempo reale che segnalano le risposte | Segnala circa il 20% delle risposte dei chatbot come potenzialmente frutto di allucinazioni. |
Il dato più eclatante è il divario tra l'adozione di RAG (68%) e l'adozione di strumenti di verifica dedicati (19%). La maggior parte delle aziende si affida alla mitigazione basata sul recupero e alla revisione umana piuttosto che a sistemi automatizzati di verifica dei fatti specificamente progettati per il rilevamento delle allucinazioni, il che significa che una parte significativa dell'implementazione dell'IA aziendale dipende ancora da una persona che individua l'errore prima che causi un problema.
Conclusione
La storia delle allucinazioni che emerge dai benchmark di rilascio dei modelli — tassi di errore inferiori all'1.5% — e la storia delle allucinazioni che si manifesta nei test reali specifici del settore — che arrivano fino all'88% nella ricerca legale — descrivono gli stessi modelli ma realtà quasi completamente diverse. I benchmark generali misurano l'efficacia con cui un modello gestisce fatti semplici e ben documentati; i settori specializzati rivelano con quale frequenza inventa risposte plausibili quando le informazioni reali sono oscure o assenti dai dati di addestramento. La buona notizia è che questo divario è colmabile: la generazione aumentata dal recupero e l'ancoraggio degli strumenti riducono i tassi di allucinazione del 65-90%, superando di gran lunga i trucchi di prompt. La notizia meno rassicurante è che l'adozione aziendale di strumenti di verifica dedicati è ancora ferma al 19%, il che significa che la maggior parte delle organizzazioni che implementano l'IA in settori ad alto rischio si affida ancora in larga misura agli esseri umani per individuare gli errori che il modello non sa di commettere.
Domande frequenti
In base ai parametri di riferimento generali, i tassi di allucinazioni sono diminuiti di circa il 96% dal 2021, rendendo le medie complessive incredibilmente basse. Tuttavia, in ambiti specifici come quello legale e medico, i tassi di allucinazioni si attestano ancora tra il 43% e l'88%, il che significa che il dato di riferimento raramente riflette le prestazioni nel mondo reale.
La ricerca giuridica richiede al modello di produrre citazioni esatte di casi e sentenze specifiche per giurisdizione, il che è molto più difficile che riassumere documenti o rispondere a domande di cultura generale. Questo è il motivo per cui i tassi di allucinazione aumentano da circa il 6.4% nei compiti giuridici più semplici al 58-88% quando i modelli vengono testati su quesiti di ricerca giuridica specifici e reali.
Un sistema RAG ben implementato può ridurre il tasso di allucinazioni del 75-90% basando l'IA su documenti di origine verificati. Detto questo, anche le implementazioni RAG più robuste producono comunque allucinazioni nel 5-15% dei casi, in genere quando la fase di recupero non riesce a individuare il materiale corretto.
No, la sola ingegneria istantanea è significativamente meno efficace di soluzioni architettoniche come RAG e il grounding degli strumenti. I dati suggeriscono che gli approcci basati sul grounding offrono una riduzione del tasso di allucinazioni da cinque a sei volte maggiore rispetto alla sola ingegneria istantanea.
Non è sicuro: i tassi di allucinazioni nei test su quesiti medici specifici variano dal 43 all'88%, una percentuale troppo elevata per agire senza un riscontro incrociato con un professionista qualificato o una fonte clinica primaria. I risultati dell'IA in medicina e diritto dovrebbero essere considerati un punto di partenza per la ricerca, non una risposta definitiva.