Сторінки релізів моделей люблять рекламувати низькі показники галюцинацій — менше 1% у стандартних тестах на точність. Ці цифри реальні. Вони також майже безглузді для тих областей, де галюцинації мають найбільше значення. У цій статті відшліфовані контрольні показники порівнюються з перевіреними в реальних умовах показниками з юридичної, медичної та корпоративної сфер, і показано, чому розрив між ними є однією з найменш обговорюваних проблем у сфері штучного інтелекту зараз.
Що таке галюцинації штучного інтелекту?
Галюцинація — це коли модель штучного інтелекту впевнено та вільно заявляє про щось, що є фактично неправильним або повністю вигаданим — фальшиву судову справу, сфабриковану статистику, медичне твердження без підстав, цитату, якої не існує. Небезпека полягає не в тому, що штучний інтелект помиляється. Небезпека полягає в тому, що галюцинована відповідь зазвичай виглядає так само відшліфовано та впевнено, як і правильна, саме тому її важко розпізнати без перевірки.
Порівняльні показники: що рекламується
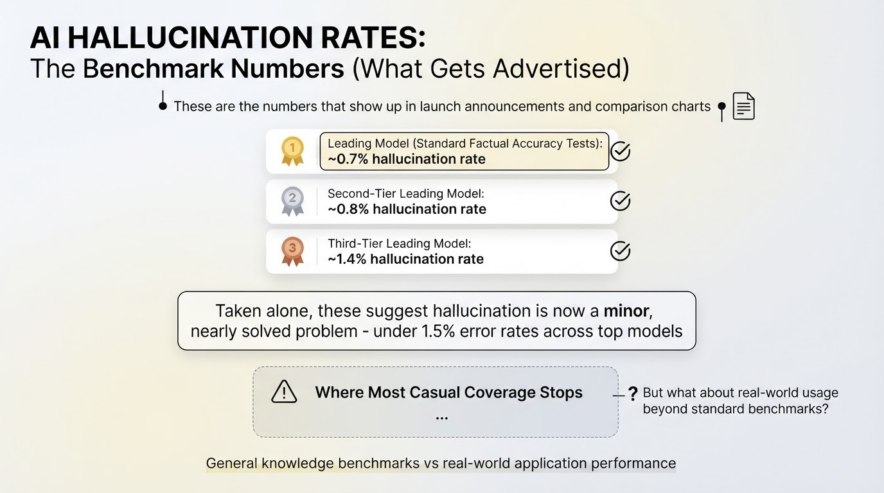
Модель (загальний тест знань) | Швидкість галюцинацій |
Провідна модель на стандартних тестах на фактичну точність | ~ 0.7% |
Провідна модель другого рівня | ~ 0.8% |
Провідна модель третього рівня | ~ 1.4% |
Це цифри, які відображаються в оголошеннях про запуск та порівняльних таблицях. Взяті окремо, вони свідчать про те, що галюцинації зараз є незначною, майже вирішеною проблемою — рівень помилок у топових моделях становить менше 1.5%. На цьому більшість неформального висвітлення цієї теми закінчується.
Числа реального світу: що відбувається в певних областях
сфера | Швидкість галюцинацій | Джерело / Контекст |
Загальний бенчмарк знань (маркетинговий показник) | 0.7-1.4% | Стандартизовані тести на фактичну точність |
Юридичний ШІ, завдання, пов'язані з предметною областю (середній рівень) | ~ 6.4% | Середній показник галузі за юридичними випадками використання |
Юридичний ШІ, конкретні юридичні запити (дослідження Стенфорда) | 58-88% | Тестування основних моделей на реальних питаннях юридичних досліджень |
Медичний ШІ, предметно-орієнтовані завдання (середній рівень) | 10-20% | Середній показник галузі за медичними випадками використання |
Медичний штучний інтелект, тестування, що залежить від швидкості та якості | 43-64% | Залежно від того, як було сформульовано питання |
Розрив тут величезний — не маленька різниця, а різниця, що вимірюється десятками кратних. Модель, яка галюцинує менше ніж у 1% випадків у загальному тесті вікторини, може галюцинувати у більш ніж половині реальних дослідницьких питань у галузі права. Це число, яке по суті ніколи не з'являється в одному реченні з маркетинговим тестом, хоча обидва описують одні й ті ж базові моделі.
Чому розрив такий великий
Кілька факторів пояснюють, чому рівень галюцинацій, пов'язаних з певною областю, набагато вищий, ніж показують загальні показники:
Загальні бенчмарки перевіряють прості, добре задокументовані факти — столиці, фундаментальна наука, загальновідомі дані, що постійно та послідовно з'являються в навчальних даних моделі
Юридичні та медичні запити вимагають точної, конкретної та часто незрозумілої інформації — посилання на конкретний випадок, конкретну взаємодію лікарських засобів, конкретну регуляторну деталь — де бути «майже» до правильного функціонально те саме, що й бути неправильним
Моделей навчають звучати впевнено, незалежно від невизначеності — немає вбудованого механізму, який би змушував модель казати «Я не знаю» замість того, щоб генерувати правдоподібну, але вигадану відповідь
Спеціалізовані домени мають менше повторюваних, надлишкових навчальних даних — модель бачить багато описів поширених фактів і дуже мало описів якоїсь окремої маловідомої юридичної справи, що полегшує моделі змішування або винаходження деталей
Вартість бізнесу
Галюцинації — це не просто статистика точності, вони несуть вимірні фінансові витрати, які зростають зі збільшенням їх поширення.
Metric | Figure |
Орієнтовні глобальні витрати бізнесу, пов'язані з галюцинаціями, пов'язаними зі штучним інтелектом, у 2024 році | 67.4 млрд доларів |
Прогнозована вартість, 2025 | 112 млрд доларів |
Trend | Зростання в ногу з усиновленням, а не падіння |
Це той випадок, коли ширше впровадження збільшує сукупну вартість проблеми, навіть попри те, що точність окремих моделей поступово покращується — чим більше людей покладаються на результати ШІ для прийняття суттєвих рішень, тим більше можливостей для того, щоб непомічена галюцинація завдала реальної шкоди.
Що насправді зменшує галюцинації (а що ні)
Це та частина даних, яка справді корисна для будь-кого, хто впроваджує штучний інтелект у реальному робочому процесі.
Методи, ранжовані за ефективністю:
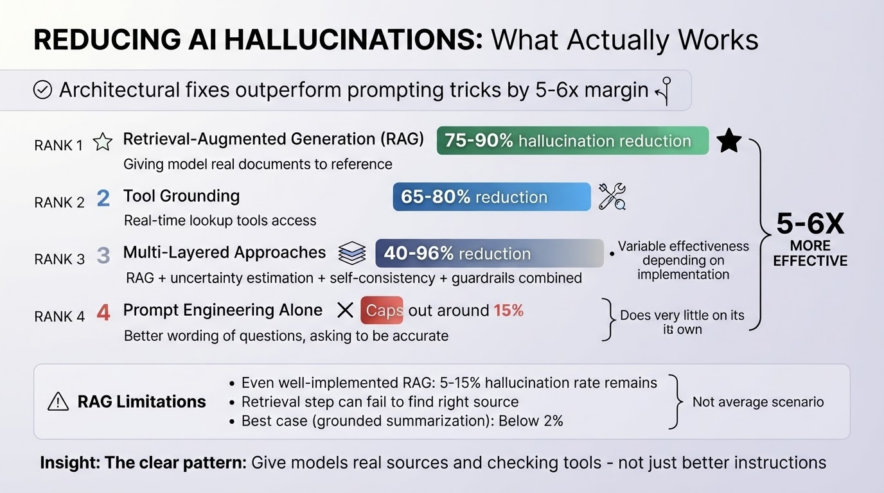
Техніка | Зменшення галюцинацій |
Генерація з розширеним пошуком (RAG) | 75-90% |
Заземлення інструментів (надання моделі доступу до інструментів пошуку в режимі реального часу) | 65-80% |
Багаторівневі підходи (RAG + оцінка невизначеності + самоузгодженість + захисні огородження разом) | 40-96% |
Тільки швидке проектування (краще формулювання питання) | Обмежується приблизно 15% |
Закономірність зрозуміла: архітектурні виправлення — надання моделі реальних документів для довідки та інструментів для перевірки її роботи — значно перевершують трюки з підказками, приблизно в п'ять-шість разів ефективніше. Просте ретельніше запитання до моделі або наказ «бути точною» саме по собі мало що дає.
Де RAG все ще не дотягує:
Навіть добре реалізовані системи RAG все ще викликають галюцинації у 5-15% випадків, зазвичай коли сам етап пошуку не дозволяє знайти потрібний вихідний документ. Завдання обґрунтованого узагальнення можуть знизити рівень галюцинацій нижче 2%, але це найкращий сценарій, а не середній.
Як підприємства насправді виявляють ці помилки
Метод виявлення/пом'якшення наслідків | Прийняття підприємства |
RAG як автоматизоване пом'якшення наслідків | 68% підприємств |
Процеси перевірки з участю людини | 76% підприємств |
Спеціальні API перевірки | Лише 19% підприємств |
Системи виявлення в режимі реального часу, що сигналізують про реакції | Позначте приблизно 20% відповідей чат-ботів як потенційно галюцинаційні |
Вражаючим показником тут є розрив між впровадженням RAG (68%) та впровадженням спеціалізованих інструментів перевірки (19%). Більшість компаній покладаються на методи пом'якшення наслідків на основі пошуку та перевірку людиною, а не на автоматизовані системи перевірки фактів, спеціально створені для виявлення галюцинацій, що означає, що значна частка впровадження штучного інтелекту в підприємствах все ще залежить від того, чи виявить людина помилку до того, як вона спричинить проблему.
Висновок
Історія галюцинацій, яку розповідають через бенчмарки випуску моделей — рівень помилок менше 1.5% — та історія галюцинацій, яка проявляється в реальному тестуванні предметної області — до 88% у юридичних дослідженнях — описують ті самі моделі, але майже зовсім різні реалії. Загальні бенчмарки вимірюють, наскільки добре модель обробляє прості, добре задокументовані факти; спеціалізовані галузі показують, як часто вона створює правдоподібні відповіді, коли реальна інформація незрозуміла або відсутня в навчальних даних. Гарна новина в даних полягає в тому, що цю прогалину можна заповнити: генерація з доповненим пошуком даних та заземлення інструментів знижують рівень галюцинацій на 65-90%, значно перевершуючи хитрощі підказок. Менш втішна новина полягає в тому, що впровадження спеціалізованих інструментів перевірки підприємствами все ще становить лише 19%, а це означає, що більшість організацій, які розгортають ШІ у високовартісних сферах, все ще сильно покладаються на людей, які виявляють помилки, про які модель не знає.
Поширені запитання
За загальними критеріями, рівень галюцинацій знизився приблизно на 96% з 2021 року, що робить загальні середні показники вражаюче низькими. Однак, у специфічних для певної галузі завданнях у юриспруденції та медицині рівень галюцинацій все ще становить 43-88%, а це означає, що показник, що відображає реальні показники, рідко відображає реальну ефективність.
Для юридичних досліджень модель повинна створювати точні цитати зі справ та рішення, що стосуються конкретних юрисдикцій, що набагато складніше, ніж узагальнення документів або відповіді на запитання загальних знань. Саме тому рівень галюцинацій зростає з приблизно 6.4% у простих юридичних завданнях до 58-88%, коли моделі тестуються на конкретних, реальних запитах юридичних досліджень.
Добре впроваджена система RAG може знизити рівень галюцинацій на 75-90%, базуючись на перевірених вихідних документах як на штучному інтелекті. Проте, навіть потужні реалізації RAG все одно призводять до галюцинацій у 5-15% випадків, зазвичай коли на етапі пошуку не вдається знайти потрібний матеріал.
Ні, саме по собі оперативне проектування значно менш ефективне, ніж архітектурні рішення, такі як RAG та заземлення інструментів. Дані свідчать про те, що підходи на основі заземлення забезпечують приблизно в п'ять-шість разів більше зниження рівня галюцинацій порівняно з самим оперативним проектуванням.
Небезпечно — рівень галюцинацій у тестуванні конкретних медичних запитів коливається від 43 до 88%, що занадто високо, щоб діяти на основі цього без перехресної перевірки з кваліфікованим фахівцем або первинним клінічним джерелом. Результати ШІ в медицині та юриспруденції найкраще розглядати як відправну точку дослідження, а не як остаточну відповідь.