Umfrage um Umfrage bestätigt: Die meisten Unternehmen nutzen mittlerweile Open-Source-KI. Ob 89 Prozent, 63 Prozent oder „nahezu flächendeckend“ – die Zahlen deuten alle in dieselbe Richtung. Doch betrachtet man die tatsächliche Nutzung, gemessen an verarbeiteten Token statt an abgehakten Kontrollkästchen, ergibt sich ein ganz anderes Bild. Dieser Artikel stellt die Ergebnisse von Adoptionsumfragen den realen Nutzungsdaten gegenüber und zeigt, warum die Aussagen „Wir nutzen Open Source“ und „Unsere KI-Entwicklung findet tatsächlich in Open Source statt“ nicht dasselbe sind.
Die wichtigsten Adoptionszahlen
Umfragemetrik | Abbildung |
Organisationen, die bereits in irgendeiner Form Open-Source-KI nutzen | 63% |
Organisationen, die Open-Source-Software an irgendeiner Stelle in ihrer KI-Architektur einsetzen | 89% |
KI-Projekte, die Open-Source-Modelle während der Entwicklung integrieren | 60% + |
Unternehmen, die mindestens ein Open-Source-Modell in der Produktion einsetzen | 89% |
Für sich genommen deuten diese Zahlen darauf hin, dass Open-Source-KI sich im Wesentlichen durchgesetzt hat – mit einer nahezu flächendeckenden Einführung in der Unternehmens-KI. Diese Version der Geschichte wird in der Branchenberichterstattung am häufigsten wiedergegeben.
Die Zahl, die eine andere Geschichte erzählt: Wohin die Token tatsächlich gehen
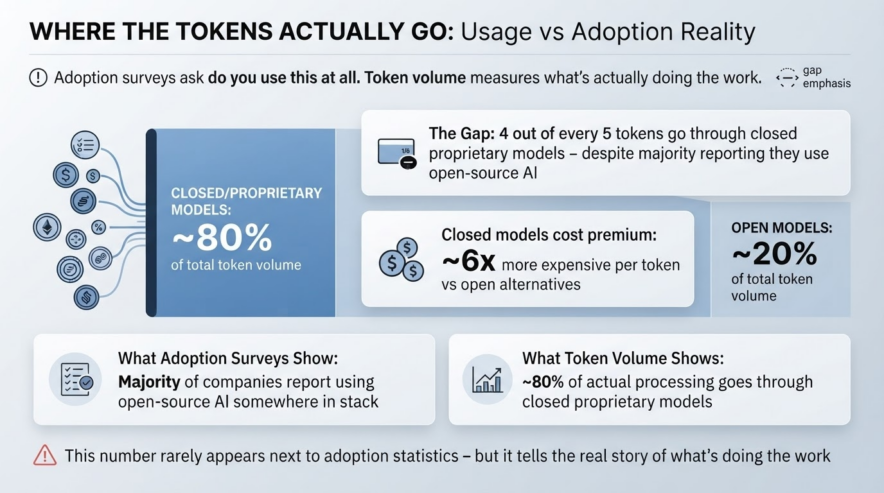
Nutzungsbefragungen fragen: „Nutzen Sie das überhaupt?“ Das Tokenvolumen misst hingegen, was tatsächlich funktioniert. Die Differenz zwischen beiden ist die eigentliche Aussagekraft.
Metrisch | Abbildung |
Anteil des gesamten KI-Tokenvolumens, der in geschlossene (proprietäre) Modelle fließt | ~ 80% |
Anteil des gesamten KI-Token-Volumens, der an offene Modelle fließt | ~ 20% |
Durchschnittlicher Kostenaufschlag geschlossener Modelle pro Token im Vergleich zu offenen Alternativen | etwa 6-mal teurer |
Diese Zahl taucht selten in den Statistiken zur Akzeptanz von KI auf. Obwohl die große Mehrheit der Unternehmen angibt, Open-Source-KI in irgendeiner Form in ihrer Technologieinfrastruktur zu „nutzen“, werden branchenweit etwa vier von fünf Token tatsächlich über geschlossene, proprietäre Modelle verarbeitet – Modelle, die pro Token etwa sechsmal so teuer sind wie die verfügbaren offenen Alternativen.
Die beiden Zahlen in Einklang bringen
Das sind keine widersprüchlichen Statistiken – sie beschreiben zwei unterschiedliche Ebenen der tatsächlichen KI-Implementierung in Unternehmen:
Adoptionsstudien zählen die BreiteEin Unternehmen, das neben einer wesentlich größeren proprietären Lösung für sein wichtigstes kundenorientiertes Produkt ein kleines Open-Source-Modell für ein internes Tool einsetzt, wird in einer Umfrage als „Open Source nutzend“ gewertet – selbst wenn diese Open-Source-Nutzung nur einen winzigen Bruchteil der gesamten Aktivität ausmacht.
Tokenvolumen misst die TiefeEs erfasst, wo die eigentliche Rechenarbeit und damit der tatsächliche Geschäftswert und die Kosten konzentriert sind.
Das typische Unternehmensmuster: Open-Source-Modelle für weniger kritische, kostensensible oder spezialisierte interne Arbeitslasten; proprietäre Flaggschiffmodelle für die wichtigsten, kundenrelevantesten und leistungskritischsten Aufgaben
Dies führt zu der scheinbar seltsamen, aber beständigen Kombination aus nahezu universeller „Adoption“ und einem Tokenvolumen, das sich nach wie vor stark auf geschlossene Modelle konzentriert.
Marktgröße und Wachstum
Metrisch | Abbildung |
Marktgröße für Open-Source-KI-Modelle, 2026 | 23.08 Milliarden Dollar |
Prognostizierte Marktgröße bis 2030 | 50.03 Milliarden Dollar |
Jährliche Wachstumsrate | ~ 21.3% |
Gemeldete Kostensenkung durch den Einsatz von Open-Source-KI | Die Gesamtbetriebskosten sind um etwa 35 % niedriger. |
Der Markt wächst rasant, und der Kostenvorteil ist real und beträchtlich: Unternehmen, die wesentliche Arbeitslasten auf offene Modelle verlagern, berichten von rund einem Drittel niedrigeren Gesamtbetriebskosten. Das ist ein echter, messbarer Anreiz, der langfristig in Richtung Open Source zieht, auch wenn sich das Gesamtvolumen der Token noch nicht umgekehrt hat.
Die Leistungslücke verringert sich, ist aber noch nicht geschlossen.
Metrisch | Abbildung |
Leistungsunterschiede: Bestes geschlossenes Modell vs. bestes offenes Modell (Stand: März 2026) | 3.3% |
Geschlossene Modelle in den Top 10 der Arena-Rangliste | 6 aus 10 |
Offene Modelle unter den Top 10 | 4 aus 10 |
Die Lücke hat sich im Vergleich zu vor wenigen Jahren deutlich verringert, als Open-Source-Modelle den proprietären Flaggschiffen noch weit hinterherhinkten. Geschlossene Modelle haben aber weiterhin einen leichten Vorsprung an der Spitze der Leistungsrangliste und belegen nach wie vor die meisten Spitzenplätze – ein kleiner, aber realer Unterschied, der wahrscheinlich zum Teil erklärt, warum bei besonders anspruchsvollen Anwendungen weiterhin proprietäre Modelle bevorzugt werden.
Was geschah in der ersten Hälfte des Jahres 2026 bei den großen Open-Weight-Laboren?
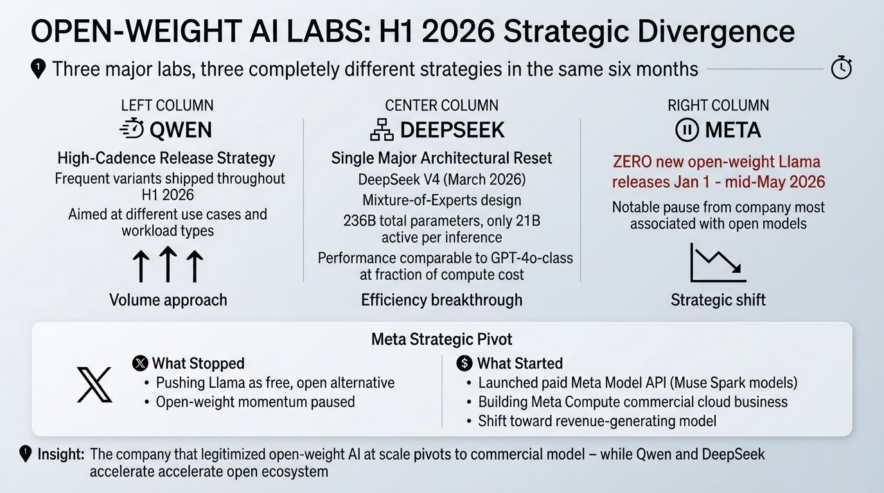
Die Landschaft im offenen Gewichtsbereich hat sich im Jahr 2026 selbst deutlich verändert, nicht nur im Vergleich zu den Vorjahren.
Qwen verfolgte eine Strategie mit hohem Release-Takt und brachte im ersten Halbjahr häufig Varianten auf den Markt, die auf unterschiedliche Anwendungsfälle und Workload-Typen abzielten.
DeepSeek DeepSeek verfolgte den gegenteiligen Ansatz und setzte auf eine grundlegende architektonische Neuausrichtung. DeepSeek V4, veröffentlicht im März 2026, verwendet ein Mixture-of-Experts-Design mit insgesamt 236 Milliarden Parametern, aber nur 21 Milliarden aktiven Parametern pro Inferenz. Dadurch wird eine mit GPT-4-Modellen vergleichbare Leistung bei einem Bruchteil der Rechenkosten erreicht.
MetaObwohl das Unternehmen mit seiner Llama-Familie zu den ersten und bekanntesten Laboren für offene KI-Modelle gehörte, veröffentlichte es zwischen dem 1. Januar und Mitte Mai 2026 keine einzige neue Llama-Version – eine bemerkenswerte Pause für das Unternehmen, das maßgeblich für die Etablierung offener Modelle im Mainstream verantwortlich ist.
Die Pause bei Meta ist besonders interessant, wenn man die weiteren Schritte des Unternehmens im Jahr 2026 betrachtet: Anstatt Llama weiterhin als kostenlose Open-Source-Alternative zu bewerben, hat Meta stattdessen eine kostenpflichtige Meta Model API für seine neueren Muse Spark-Modelle eingeführt und baut mit „Meta Compute“ ein kommerzielles Cloud-Geschäft auf. Das Unternehmen, das maßgeblich zur Etablierung von Open-Source-KI im großen Maßstab beigetragen hat, scheint zumindest einen Teil seiner Strategie in Richtung eines traditionelleren, umsatzorientierten Modells zu verlagern – selbst während der Rest des Open-Source-Ökosystems (Qwen, DeepSeek) an Fahrt gewinnt.
Warum Unternehmen sagen, dass Open Source einen besseren ROI bietet, selbst bei geringerem Tokenanteil
Eine Statistik verkompliziert die einfache Interpretation der Token-Volumen-Daten, dass „geschlossene Modelle die Nase vorn haben“: Interne Benchmarks zeigen, dass Organisationen, die Open-Source-KI-Modelle verwenden, eine um etwa 25 % höhere Kapitalrendite erzielen als Organisationen, die ausschließlich auf APIs geschlossener Modelle setzen.
Dies ist nicht unbedingt ein Widerspruch. Vielmehr spiegelt es wahrscheinlich die Selektion wider: Unternehmen, die erfolgreich Open-Source-Modelle einsetzen, tun dies tendenziell für klar definierte, kostensensible Workloads, bei denen die ROI-Berechnung günstig und leicht messbar ist. Unternehmen hingegen, die ausschließlich auf geschlossene APIs setzen, betreiben möglicherweise eine breitere und komplexere Mischung aus experimentellen und produktiven Workloads, bei denen die ROI-Messung schwieriger ist. Anders ausgedrückt: Open Source kann unter anderem deshalb einen besseren ROI aufweisen, weil es gezielter und selektiver eingesetzt wird.
Was das für die Zukunft bedeutet
Die Datenentwicklung deutet eher auf eine allmähliche Angleichung als auf einen eindeutigen Sieger hin. Der Leistungsunterschied verringert sich, der Kostenunterschied spricht deutlich für offene Modelle, und das Marktwachstum für Open-Source-KI übertrifft das Wachstum des gesamten KI-Marktes. Das Token-Volumen – die Kennzahl, die die aktuelle Rechen- und Geschäftskraft der Branche widerspiegelt – tendiert jedoch weiterhin stark zu geschlossenen Modellen, und die Veränderung dieser Kennzahl verläuft deutlich langsamer, als die Schlagzeilen in den Adoptionsumfragen vermuten lassen. Unternehmen scheinen ein tatsächlich gemischtes Umfeld zu schaffen: offene Modelle für kostensensible und spezialisierte Aufgaben, proprietäre Flaggschifflösungen für Aufgaben, bei denen die letzten Prozentpunkte an Leistung entscheidend sind.
Fazit
Die Geschichte der Einführung von Open-Source-KI und ihrer tatsächlichen Nutzung sind zwei verschiedene Dinge, und die meisten Berichte konzentrieren sich nur auf die Einführung. Umfragen zur Nutzung zeichnen das Bild einer nahezu vollständigen Durchdringung von Open-Source-KI in Unternehmen, und das ist technisch korrekt – die meisten Unternehmen nutzen sie irgendwo. Die Daten zum Token-Volumen, die tatsächlich widerspiegeln, wo Rechenleistung und Geschäftswert konzentriert sind, zeigen jedoch, dass immer noch rund 80 % der Aktivität über geschlossene, proprietäre Modelle laufen, die pro Token etwa sechsmal so viel kosten. Der eigentliche Trend ist kein reibungsloser Übergang von geschlossenen zu offenen Modellen, sondern eine zunehmende, bewusste Trennung: Offene Modelle übernehmen kostensensible und spezialisierte Workloads, während proprietäre Flaggschiffmodelle die wichtigsten Aufgaben behalten, zumindest solange, bis die schrumpfende Leistungslücke von 3.3 % vollständig geschlossen ist.
Häufig gestellte Fragen
Adoptionsstudien erfassen jedes Unternehmen, das Open-Source-KI auch nur für ein einzelnes, kleineres Tool einsetzt, während das Token-Volumen die tatsächliche Rechenlast widerspiegelt. Die meisten Unternehmen nutzen offene Modelle für kleinere, kostensensible Aufgaben, während sie ihre größten und kritischsten Operationen über proprietäre Modelle abwickeln.
Ja, deutlich. Geschlossene Modelle kosten im Durchschnitt etwa sechsmal so viel pro Token, und Unternehmen, die entsprechende Arbeitslasten auf Open-Source-Modelle umstellen, berichten von rund 35 % niedrigeren Gesamtbetriebskosten.
Sie sind zwar konkurrenzfähig, aber auf höchstem Niveau noch nicht gleichauf. Das beste geschlossene Modell übertrifft das beste offene Modell Anfang 2026 um etwa 3.3 %. Geschlossene Modelle belegen außerdem weiterhin sechs der zehn Spitzenplätze in wichtigen KI-Leistungsrankings.
Meta hat keinen offiziellen Grund genannt, doch der Zeitpunkt deckt sich mit dem Start der kostenpflichtigen Meta Model API und dem Bestreben, neuere Modelle kommerziell zu vermarkten. Dies deutet auf eine strategische Abkehr vom bisherigen Ansatz hin, bei dem die Gewichtung der Modelle im Vordergrund stand.
Qwen und DeepSeek waren die aktivsten Mitwirkenden, wobei Qwen häufige Modellaktualisierungen veröffentlichte und DeepSeek im März 2026 seine V4-Architektur auf den Markt brachte, die Berichten zufolge eine Leistung der GPT-4-Klasse bei deutlich geringeren Rechenkosten bietet.