Les pages de présentation des modèles de logiciels mettent souvent en avant des scores d'hallucination très bas — inférieurs à 1 % aux tests de précision standard. Ces chiffres sont réels. Ils sont cependant quasiment insignifiants dans les domaines où les hallucinations ont le plus d'importance. Cet article compare les chiffres théoriques, soigneusement sélectionnés, aux résultats obtenus sur le terrain dans les secteurs juridique, médical et des entreprises, et démontre pourquoi l'écart entre eux est l'un des problèmes les moins abordés en IA actuellement.
Qu'est-ce qu'une hallucination due à l'IA ?
Une hallucination se produit lorsqu'un modèle d'IA énonce avec assurance et fluidité une information factuellement fausse ou entièrement inventée : un faux procès, une statistique fabriquée de toutes pièces, une allégation médicale sans fondement, une citation inexistante. Le danger ne réside pas dans l'erreur de l'IA, mais dans le fait qu'une réponse hallucinée paraît généralement aussi bien ficelée et assurée qu'une réponse correcte, ce qui la rend difficile à déceler sans vérification.
Les chiffres de référence : ce qui est annoncé
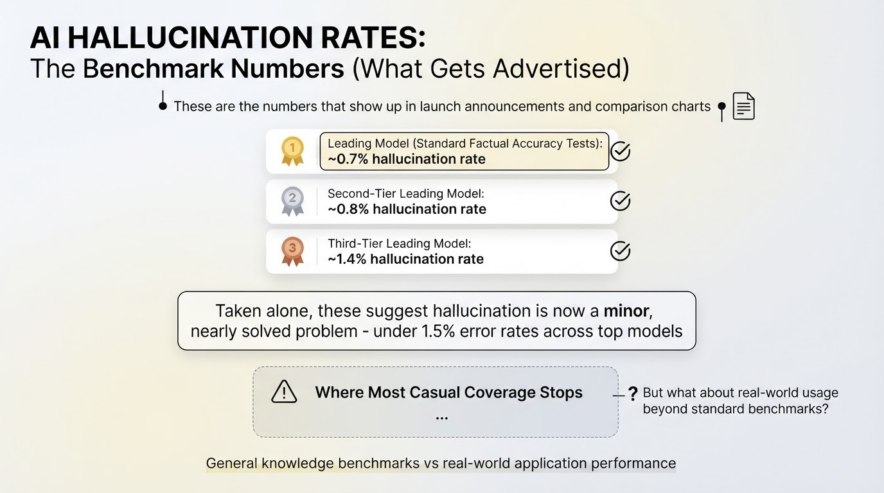
Modèle (Référence des connaissances générales) | Taux d'hallucinations |
Modèle de référence aux tests standardisés d'exactitude factuelle | ~% 0.7 |
Modèle de leader de deuxième niveau | ~% 0.8 |
Modèle de troisième niveau | ~% 1.4 |
Ce sont ces chiffres qui figurent dans les annonces de lancement et les tableaux comparatifs. Pris isolément, ils suggèrent que les hallucinations sont désormais un problème mineur, voire quasiment résolu : le taux d’erreur est inférieur à 1.5 % pour les meilleurs modèles. C’est généralement là que s’arrêtent les articles de fond sur le sujet.
Les chiffres du monde réel : ce qui se passe dans des domaines spécifiques
Domaine | Taux d'hallucinations | Source / Context |
Référence en matière de connaissances générales (chiffre marketing) | 0.7 to 1.4 % | Tests standardisés d'exactitude factuelle |
IA juridique, tâches spécifiques au domaine (moyenne) | ~% 6.4 | Moyenne du secteur pour les cas d'utilisation légale |
Intelligence artificielle juridique, requêtes juridiques spécifiques (recherche de Stanford) | 58 to 88 % | Tester les principaux modèles sur de véritables questions de recherche juridique |
IA médicale, tâches spécifiques au domaine (moyenne) | 10 to 20 % | Moyenne du secteur pour l'ensemble des cas d'utilisation médicale |
IA médicale, tests rapides dépendants de la qualité | 43 to 64 % | Selon la façon dont la question était formulée |
L'écart est ici colossal : non pas une petite différence, mais une différence qui se chiffre en dizaines de fois. Un modèle qui se trompe moins de 1 % du temps sur un test de connaissances générales peut se tromper sur plus de la moitié des questions de recherche juridique. Ce chiffre n'apparaît quasiment jamais dans la même phrase que le test de référence marketing, même si les deux décrivent les mêmes modèles sous-jacents.
Pourquoi l'écart est-il si important ?
Plusieurs facteurs expliquent pourquoi les taux d'hallucinations spécifiques à un domaine sont bien pires que ne le suggèrent les références générales :
Les tests de référence généraux portent sur des faits simples et bien documentés. — les capitales, les sciences fondamentales, les connaissances communes qui apparaissent constamment et systématiquement dans les données d'entraînement d'un modèle
Les questions juridiques et médicales nécessitent des informations précises, spécifiques et souvent obscures — une citation de cas précise, une interaction médicamenteuse spécifique, un détail réglementaire précis — où être « proche » de la vérité revient, en pratique, à se tromper.
Les modèles sont entraînés à paraître confiants, quelle que soit leur certitude. — il n’existe aucun mécanisme intégré forçant un modèle à répondre « Je ne sais pas » au lieu de générer une réponse qui semble plausible mais qui est fabriquée de toutes pièces.
Les domaines spécialisés disposent de moins de données d'entraînement répétées et redondantes. — un modèle reçoit de nombreuses descriptions de faits courants et très peu de descriptions d'affaires juridiques obscures, ce qui lui permet plus facilement de mélanger ou d'inventer des détails.
Le coût de l'entreprise
Les hallucinations ne sont pas qu'une simple statistique de précision ; elles engendrent un coût financier mesurable qui augmente à mesure que leur adoption se généralise.
Métrique | Figure |
Coût estimé pour les entreprises du monde entier des hallucinations causées par l'IA, 2024 | 67.4 milliards de dollars |
Coût prévisionnel, 2025 | 112 milliards de dollars |
Trend | Progressant au même rythme que l'adoption, et non déclinant |
Il s'agit d'un cas où une adoption plus large augmente le coût global du problème, même si la précision des modèles individuels s'améliore lentement : plus il y a de personnes qui s'appuient sur les résultats de l'IA pour prendre des décisions importantes, plus il y a de chances qu'une hallucination non détectée cause de réels dommages.
Ce qui réduit réellement les hallucinations (et ce qui ne les réduit pas)
C’est cette partie des données qui est réellement utile à quiconque déploie l’IA dans un flux de travail réel.
Techniques classées par ordre d'efficacité :
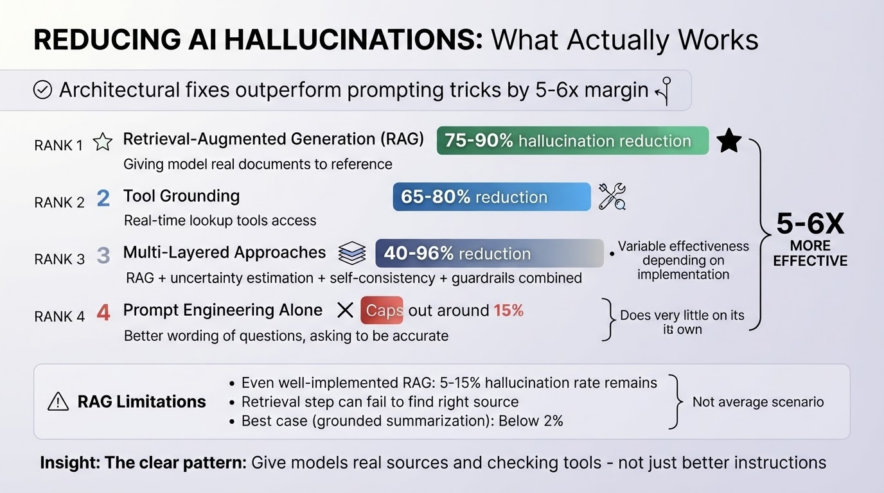
Technique | Réduction des hallucinations |
Génération augmentée par récupération (RAG) | 75 to 90 % |
Mise à la terre des outils (donner au modèle l'accès à des outils de recherche en temps réel) | 65 to 80 % |
Approches multicouches (combinaison de RAG, d'estimation de l'incertitude, d'autocohérence et de garde-fous) | 40 to 96 % |
Ingénierie rapide uniquement (meilleure formulation de la question) | Plafond aux alentours de 15% |
Le constat est clair : les corrections architecturales – fournir au modèle des documents de référence et des outils de vérification – sont bien plus efficaces que les techniques d’incitation, environ cinq à six fois plus performantes. Se contenter de demander au modèle d’être plus précis ou de lui dire d’« être exact » n’apporte que très peu de résultats.
Là où RAG présente encore des lacunes :
Même les systèmes RAG les mieux conçus produisent encore des hallucinations dans 5 à 15 % des cas, généralement lorsque l'étape de recherche elle-même ne parvient pas à trouver le document source adéquat. Les tâches de résumé ancré peuvent atteindre des taux d'hallucinations inférieurs à 2 %, mais il s'agit du scénario idéal, et non de la moyenne.
Comment les entreprises détectent réellement ces erreurs
Méthode de détection/atténuation | Adoption d'entreprise |
RAG comme mesure d'atténuation automatisée | 68% des entreprises |
Processus d'examen avec intervention humaine | 76% des entreprises |
API de vérification dédiées | Seulement 19 % des entreprises |
Systèmes de détection en temps réel signalant les réponses | Environ 20 % des réponses des chatbots sont signalées comme potentiellement hallucinatoires. |
Le chiffre le plus frappant est l'écart entre l'adoption des outils de vérification rapide (68 %) et celle des outils de vérification dédiés (19 %). La plupart des entreprises privilégient les mesures d'atténuation basées sur la récupération et la vérification humaine plutôt que les systèmes automatisés de vérification des faits spécifiquement conçus pour détecter les erreurs. Autrement dit, une part importante du déploiement de l'IA en entreprise repose encore sur la capacité d'une personne à repérer l'erreur avant qu'elle ne cause un problème.
Conclusion
L'histoire des hallucinations révélée par les tests de validation de modèles (taux d'erreur inférieurs à 1.5 %) et celle observée lors de tests réels et spécifiques à un domaine (jusqu'à 88 % dans la recherche juridique) décrivent les mêmes modèles, mais des réalités presque totalement différentes. Les tests généraux évaluent la capacité d'un modèle à traiter des faits simples et bien documentés ; les domaines spécialisés révèlent la fréquence à laquelle il fabrique des réponses plausibles lorsque l'information réelle est obscure ou absente de ses données d'entraînement. La bonne nouvelle, c'est que cet écart est comblable : la génération augmentée par la recherche et l'ancrage des outils réduisent les taux d'hallucinations de 65 à 90 %, surpassant largement les astuces de manipulation des amorces. La moins rassurante, c'est que l'adoption par les entreprises d'outils de vérification dédiés n'atteint que 19 %, ce qui signifie que la plupart des organisations déployant l'IA dans des domaines à forts enjeux dépendent encore fortement de la capacité humaine à détecter les erreurs que le modèle commet sans s'en rendre compte.
Questions fréquemment posées
De manière générale, les taux d'hallucinations ont chuté d'environ 96 % depuis 2021, ce qui explique les moyennes globales remarquablement basses. Cependant, pour des tâches spécifiques au droit et à la médecine, ces taux restent élevés, de l'ordre de 43 à 88 %, ce qui signifie que les données de référence reflètent rarement les performances réelles.
La recherche juridique exige du modèle qu'il produise des citations de jurisprudence exactes et des décisions spécifiques à chaque juridiction, ce qui est bien plus complexe que de résumer des documents ou de répondre à des questions de culture générale. C'est pourquoi le taux d'erreurs passe d'environ 6.4 % pour des tâches juridiques simples à 58-88 % lorsque les modèles sont testés sur des requêtes de recherche juridique réelles et spécifiques.
Un système RAG bien implémenté peut réduire le taux d'hallucinations de 75 à 90 % en s'appuyant sur des documents sources vérifiés. Cependant, même les systèmes RAG les plus performants produisent encore des hallucinations dans 5 à 15 % des cas, généralement lorsque la recherche ne parvient pas à trouver le document pertinent.
Non, l'ingénierie rapide seule est nettement moins efficace que des solutions architecturales comme RAG et la mise à la terre des outils. Les données suggèrent que les approches basées sur la mise à la terre permettent une réduction des hallucinations environ cinq à six fois supérieure à celle obtenue par l'ingénierie rapide seule.
Attention ! Les taux d’hallucinations observés lors de tests de requêtes médicales spécifiques varient de 43 à 88 %, un niveau beaucoup trop élevé pour se baser sur ces résultats sans vérification auprès d’un professionnel qualifié ou d’une source clinique de référence. En médecine et en droit, les résultats de l’IA doivent être considérés comme un point de départ pour la recherche, et non comme une réponse définitive.