Survei demi survei mengatakan hal yang sama: sebagian besar perusahaan sekarang menggunakan AI sumber terbuka. Delapan puluh sembilan persen, enam puluh tiga persen, "hampir universal" — pilih angka mana pun, semuanya mengarah ke arah yang sama. Tetapi ketika Anda melihat ke mana arah penggunaan sebenarnya, yang diukur dalam token yang diproses daripada kotak centang yang dicentang, gambaran yang sangat berbeda muncul. Artikel ini membandingkan survei adopsi dengan data penggunaan nyata, dan menunjukkan mengapa "kami menggunakan sumber terbuka" dan "sumber terbuka adalah tempat pekerjaan AI kami sebenarnya terjadi" bukanlah klaim yang sama.
Angka Adopsi Utama
Metrik Survei | Angka |
Organisasi yang sudah menggunakan AI sumber terbuka dalam beberapa bentuk | 63% |
Organisasi yang menggunakan beberapa perangkat lunak sumber terbuka di mana pun dalam tumpukan AI mereka. | 89% |
Proyek AI yang mengintegrasikan model sumber terbuka selama pengembangan | 60% + |
Perusahaan yang menerapkan setidaknya satu model sumber terbuka dalam produksi. | 89% |
Jika dilihat secara terpisah, angka-angka ini menunjukkan bahwa AI sumber terbuka pada dasarnya telah menang — adopsi yang hampir universal di seluruh AI perusahaan. Inilah versi cerita yang paling sering diulang dalam pemberitaan industri.
Angka yang Menceritakan Kisah Berbeda: Ke Mana Token Sebenarnya Ditempatkan
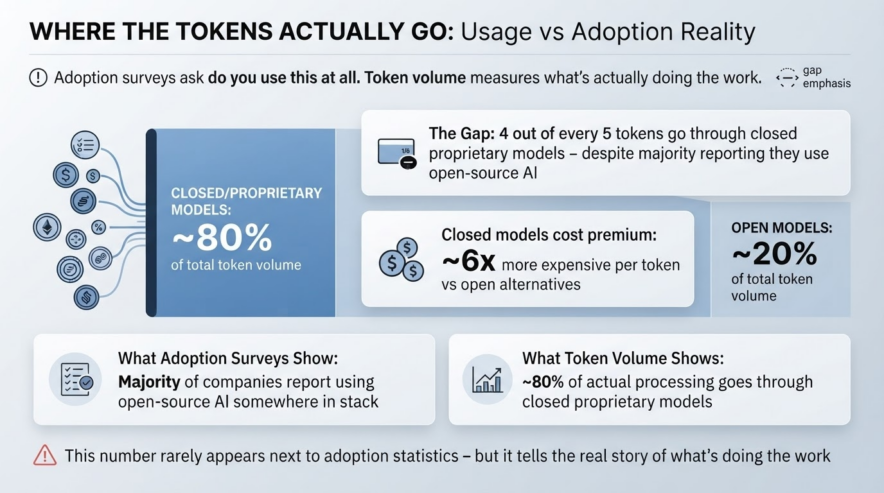
Survei adopsi menanyakan "apakah Anda menggunakannya sama sekali?" Volume token mengukur apa yang sebenarnya berfungsi. Kesenjangan antara keduanya adalah cerita sebenarnya.
metrik | Angka |
Proporsi total volume token AI yang mengalir ke model tertutup (proprietary) | ~ 80% |
Proporsi total volume token AI yang mengalir ke model terbuka | ~ 20% |
Premi biaya rata-rata model tertutup per token dibandingkan dengan alternatif terbuka. | ~6 kali lebih mahal |
Angka inilah yang jarang muncul di samping statistik adopsi. Meskipun sebagian besar perusahaan melaporkan "menggunakan" AI sumber terbuka di suatu tempat dalam tumpukan teknologi mereka, kira-kira empat dari setiap lima token yang sebenarnya diproses di seluruh industri melalui model tertutup dan berpemilik — model yang biayanya sekitar enam kali lebih mahal per token daripada alternatif terbuka yang tersedia.
Mendamaikan Kedua Angka
Ini bukanlah statistik yang saling bertentangan — statistik ini menggambarkan dua lapisan berbeda tentang bagaimana perusahaan benar-benar menerapkan AI:
Survei adopsi menghitung cakupannyaSebuah perusahaan yang menjalankan satu model sumber terbuka kecil untuk alat internal, di samping penerapan berpemilik yang jauh lebih besar untuk produk utama yang berhadapan langsung dengan pelanggan, akan dianggap "menggunakan sumber terbuka" dalam survei — meskipun penggunaan sumber terbuka tersebut hanya mewakili sebagian kecil dari total aktivitas.
Volume token mengukur kedalaman.Ini menangkap di mana pekerjaan komputasi sebenarnya, dan karenanya nilai dan biaya bisnis sebenarnya, terkonsentrasi.
Pola perusahaan tipikal: model sumber terbuka untuk beban kerja internal yang berisiko rendah, sensitif terhadap biaya, atau khusus; model unggulan berpemilik untuk pekerjaan yang berisiko tinggi, paling terlihat oleh pelanggan, dan paling kritis terhadap kinerja.
Hal ini menghasilkan kombinasi yang tampaknya aneh namun konsisten, yaitu "adopsi" yang hampir universal di samping volume token yang masih sangat terkonsentrasi pada model tertutup.
Ukuran dan Pertumbuhan Pasar
metrik | Angka |
Ukuran pasar model AI sumber terbuka, 2026 | $ 23.08 miliar |
Ukuran pasar yang diproyeksikan pada tahun 2030 | $ 50.03 miliar |
Tingkat pertumbuhan tahunan majemuk | ~ 21.3% |
Dilaporkan adanya pengurangan biaya dari penggunaan AI sumber terbuka. | Biaya kepemilikan total ~35% lebih rendah |
Pasar ini benar-benar berkembang pesat, dan keunggulan biayanya nyata dan substansial — perusahaan yang mengalihkan beban kerja yang signifikan ke model sumber terbuka melaporkan biaya kepemilikan total sekitar sepertiga lebih rendah. Itu adalah insentif nyata dan terukur yang mendorong ke arah sumber terbuka dari waktu ke waktu, meskipun belum mengubah keseimbangan volume token secara keseluruhan.
Kesenjangan Kinerja Semakin Menipis, Tetapi Belum Sepenuhnya Tertutup
metrik | Angka |
Selisih performa, model tertutup terbaik vs. model terbuka terbaik (per Maret 2026) | 3.3% |
Model tertutup berada di 10 besar Papan Peringkat Arena. | 6 10 dari |
Model terbuka di 10 teratas | 4 10 dari |
Selisihnya telah menyempit secara signifikan dibandingkan beberapa tahun sebelumnya, ketika model open source tertinggal jauh dari flagship proprietary. Namun, model closed source masih memiliki sedikit keunggulan di peringkat teratas performa, dan masih mendominasi sebagian besar posisi teratas di papan peringkat — selisih kecil namun nyata yang kemungkinan menjelaskan sebagian alasan mengapa beban kerja dengan risiko tertinggi masih cenderung mengarah ke model proprietary.
Apa yang Terjadi di Antara Laboratorium-Laboratorium Utama yang Menggunakan Material Bobot Terbuka pada Paruh Pertama Tahun 2026?
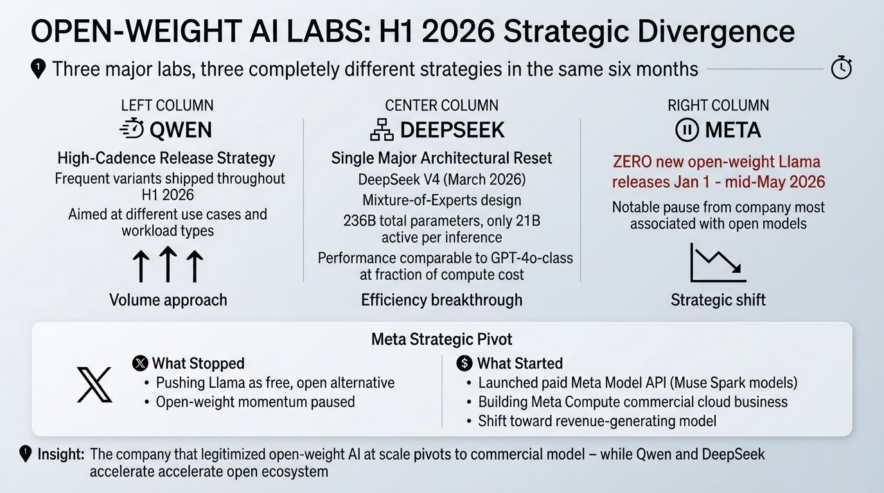
Lanskap tinju kelas terbuka berubah secara signifikan pada tahun 2026 itu sendiri, bukan hanya relatif terhadap tahun-tahun sebelumnya.
Qwen Menerapkan strategi rilis dengan frekuensi tinggi, mengirimkan varian yang sering ditujukan untuk berbagai kasus penggunaan dan jenis beban kerja sepanjang paruh pertama tahun ini.
Pencarian Mendalam Mengambil pendekatan yang berlawanan, bertaruh pada satu perubahan arsitektur utama — DeepSeek V4, yang dirilis pada Maret 2026, menggunakan desain Mixture-of-Experts dengan total 236 miliar parameter tetapi hanya 21 miliar yang aktif per inferensi, mencapai kinerja yang sebanding dengan model kelas GPT-4o dengan sebagian kecil biaya komputasi.
metaMeskipun menjadi salah satu lab AI open-weight paling awal dan terkemuka dengan keluarga Llama-nya, perusahaan tersebut tidak merilis satu pun produk Llama open-weight baru antara 1 Januari dan pertengahan Mei 2026 — sebuah jeda yang mencolok dari perusahaan yang paling dikenal karena mendorong model open-weight ke arus utama.
Jeda yang dilakukan Meta tersebut merupakan poin data yang sangat menarik mengingat langkah-langkah lain perusahaan di tahun 2026: alih-alih terus mendorong Llama sebagai alternatif gratis dan terbuka, Meta malah meluncurkan API Meta Model berbayar di sekitar model Muse Spark yang lebih baru dan sedang membangun "Meta Compute," sebuah bisnis cloud komersial. Perusahaan yang membantu melegitimasi AI open-weight dalam skala besar tampaknya menggeser setidaknya sebagian strateginya ke arah model yang lebih tradisional dan menghasilkan pendapatan — bahkan ketika ekosistem open-weight lainnya (Qwen, DeepSeek) semakin berkembang pesat.
Mengapa Perusahaan Mengatakan Sumber Terbuka Memberikan ROI yang Lebih Baik, Bahkan dengan Pembagian Token yang Lebih Rendah
Satu statistik mempersulit interpretasi sederhana "model tertutup menang" dari data volume token: tolok ukur internal menunjukkan bahwa organisasi yang menggunakan model AI sumber terbuka melaporkan pengembalian investasi sekitar 25% lebih tinggi dibandingkan dengan organisasi yang hanya mengandalkan API model tertutup.
Ini belum tentu sebuah kontradiksi. Kemungkinan besar ini mencerminkan seleksi: perusahaan yang berhasil menerapkan model sumber terbuka cenderung melakukannya untuk beban kerja yang terdefinisi dengan baik dan sensitif terhadap biaya di mana perhitungan ROI menguntungkan dan mudah diukur — sementara perusahaan yang sepenuhnya mengandalkan API tertutup mungkin menjalankan campuran beban kerja eksperimental dan produksi yang lebih luas dan rumit di mana pengukuran ROI yang akurat lebih sulit. Dengan kata lain, sumber terbuka mungkin menunjukkan angka ROI yang lebih baik sebagian karena diterapkan secara lebih sengaja dan selektif.
Apa Artinya Ke Depan
Tren data menunjukkan konvergensi bertahap daripada pemenang yang jelas. Kesenjangan kinerja semakin mengecil, kesenjangan biaya sangat menguntungkan model terbuka, dan pertumbuhan pasar AI sumber terbuka melampaui pertumbuhan pasar AI secara keseluruhan. Namun, volume token—angka yang benar-benar mencerminkan bobot komputasi dan bisnis industri saat ini—masih sangat condong ke model tertutup, dan pergeseran angka tersebut jauh lebih lambat daripada yang disarankan oleh berita utama survei adopsi. Perusahaan tampaknya sedang membangun lingkungan yang benar-benar beragam: model terbuka untuk pekerjaan yang sensitif terhadap biaya dan khusus, dan produk unggulan berpemilik untuk pekerjaan di mana beberapa poin persentase kinerja terakhir masih sangat penting.
Kesimpulan
Kisah adopsi AI sumber terbuka dan kisah penggunaan AI sumber terbuka bukanlah kisah yang sama, dan sebagian besar liputan hanya menceritakan yang pertama. Survei adopsi menggambarkan penetrasi sumber terbuka yang hampir total di seluruh AI perusahaan, dan secara teknis itu akurat — sebagian besar perusahaan memang menggunakannya di suatu tempat. Tetapi data volume token, angka yang sebenarnya mencerminkan di mana pekerjaan komputasi dan nilai bisnis terkonsentrasi, menunjukkan sekitar 80% aktivitas masih mengalir melalui model tertutup dan berpemilik yang harganya sekitar enam kali lebih mahal per token. Tren sebenarnya bukanlah peralihan yang mulus dari model tertutup ke model terbuka — melainkan perpecahan yang semakin lebar dan lebih disengaja, dengan model terbuka menyerap beban kerja yang sensitif terhadap biaya dan khusus sementara model unggulan berpemilik mempertahankan pekerjaan dengan risiko tertinggi, setidaknya sampai kesenjangan kinerja 3.3% yang semakin menyusut itu tertutup sepenuhnya.
Pertanyaan yang Sering Diajukan
Survei adopsi menghitung setiap perusahaan yang menggunakan AI sumber terbuka, bahkan untuk satu alat kecil sekalipun, sementara volume token mencerminkan beban kerja komputasi yang sebenarnya. Sebagian besar perusahaan mengandalkan model terbuka untuk tugas-tugas kecil dan sensitif biaya, sementara operasi terbesar dan paling berisiko tinggi mereka dialihkan melalui model berpemilik.
Ya, secara signifikan. Model tertutup rata-rata membutuhkan biaya sekitar enam kali lebih banyak per token, dan bisnis yang mengalihkan beban kerja yang relevan ke model sumber terbuka melaporkan biaya kepemilikan total sekitar 35% lebih rendah.
Mereka kompetitif tetapi belum setara di level tertinggi, dengan model tertutup terbaik mengungguli model terbuka terbaik sekitar 3.3% pada awal tahun 2026. Model tertutup juga masih menduduki enam dari sepuluh posisi teratas di papan peringkat kinerja AI utama.
Meta belum memberikan satu pun alasan resmi, tetapi waktunya bertepatan dengan peluncuran API Meta Model berbayar dan upaya untuk memonetisasi model-model baru secara komersial. Ini menunjukkan pergeseran strategis dari pendekatan sebelumnya yang mengutamakan bobot terbuka.
Qwen dan DeepSeek telah menjadi kontributor paling aktif, dengan Qwen merilis pembaruan model secara berkala dan DeepSeek meluncurkan arsitektur V4-nya pada Maret 2026, yang dilaporkan memberikan kinerja kelas GPT-4 dengan biaya komputasi yang jauh lebih rendah.