На страницах, посвященных выпуску моделей, часто рекламируются низкие показатели галлюцинаций — менее 1% в стандартных тестах на точность. Эти цифры реальны. Однако они практически бессмысленны для тех областей, где галлюцинации имеют наибольшее значение. В этой статье сопоставляются отточенные эталонные показатели с результатами полевых испытаний в юридической, медицинской и корпоративной сферах, и показано, почему разрыв между ними является одной из наименее обсуждаемых проблем в области ИИ на данный момент.
Что такое галлюцинация, вызванная искусственным интеллектом?
Галлюцинация — это когда модель ИИ уверенно и бегло излагает факты, которые на самом деле неверны или полностью выдуманы — сфабрикованное судебное дело, сфабрикованная статистика, медицинское утверждение, не имеющее под собой оснований, несуществующая ссылка. Опасность заключается не в том, что ИИ ошибается. Опасность в том, что галлюцинаторный ответ обычно выглядит так же безупречно и уверенно, как и правильный, поэтому его трудно обнаружить без проверки.
Контрольные показатели: что рекламируется?
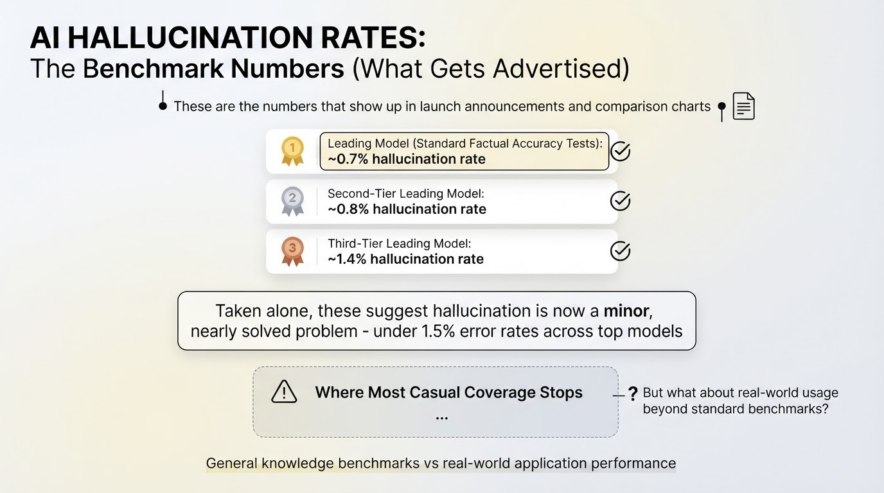
Модель (эталон общих знаний) | Частота галлюцинаций |
Ведущая модель в стандартных тестах на фактическую точность. | ~ 0.7% |
Модель лидера второго эшелона | ~ 0.8% |
Модель лидера третьего уровня | ~ 1.4% |
Эти цифры фигурируют в анонсах новых моделей и сравнительных таблицах. Взятые сами по себе, они говорят о том, что галлюцинации теперь являются незначительной, почти решенной проблемой — частота ошибок в топовых моделях составляет менее 1.5%. На этом большинство неформальных обсуждений этой темы и заканчиваются.
Реальные цифры: что происходит в конкретных областях
Домен | Частота галлюцинаций | Источник/Контекст |
Общий уровень знаний (маркетинговый показатель) | 0.7-1.4% | Стандартизированные тесты на фактическую точность |
Искусственный интеллект в юридической сфере, задачи, специфичные для конкретной области (в среднем) | ~ 6.4% | Средние показатели по отрасли по всем юридически обоснованным вариантам использования |
Искусственный интеллект в юриспруденции, конкретные юридические запросы (исследование Стэнфордского университета) | 58-88% | Тестирование основных моделей на реальных вопросах юридических исследований. |
Медицинский ИИ, задачи, специфичные для конкретной области (в среднем) | 10-20% | Средние показатели по отрасли в различных медицинских областях применения |
Медицинский ИИ, оперативное тестирование, зависящее от качества. | 43-64% | В зависимости от того, как был сформулирован вопрос. |
Разница здесь огромна — не просто небольшая, а измеряемая десятками раз. Модель, которая дает ложные срабатывания менее чем в 1% случаев при решении общих вопросов викторины, может давать ложные срабатывания более чем в половине реальных вопросов юридических исследований. Это число практически никогда не встречается в одном предложении с маркетинговым эталоном, хотя оба описывают одни и те же базовые модели.
Почему разрыв так велик?
Несколько факторов объясняют, почему показатели галлюцинаций в конкретных областях значительно хуже, чем показывают общие контрольные показатели:
Общие контрольные показатели проверяют простые и хорошо документированные факты. — столицы, фундаментальные научные знания, общеизвестные факты, которые постоянно и непротиворечиво встречаются в обучающих данных модели.
Для юридических и медицинских запросов требуется точная, конкретная и зачастую неясная информация. — конкретная ссылка на прецедент, конкретное лекарственное взаимодействие, конкретная нормативная деталь — где быть «близким» к правильному функционально равнозначно быть неправильным.
Модели обучены говорить уверенно, независимо от степени уверенности. — Встроенного механизма, заставляющего модель отвечать «Я не знаю» вместо того, чтобы генерировать правдоподобно звучащий, но вымышленный ответ, не существует.
В специализированных областях меньше повторяющихся, избыточных обучающих данных. — Модель видит множество описаний общеизвестных фактов и очень мало описаний отдельных малоизвестных юридических дел, что облегчает ей объединение или создание новых деталей.
Бизнес-затраты
Галлюцинации — это не просто статистический показатель точности, они влекут за собой измеримые финансовые издержки, которые растут по мере увеличения их распространения.
Метрика | Figure |
Оценочные глобальные издержки для бизнеса, связанные с галлюцинациями, вызванными искусственным интеллектом, в 2024 году. | расходы на видеорекламу в мире достигнут |
Прогнозируемая стоимость, 2025 год | расходы на видеорекламу в мире достигнут |
тенденция | Растет в ногу с ростом уровня внедрения, а не снижается. |
В данном случае более широкое внедрение приводит к увеличению совокупных затрат на решение проблемы, даже несмотря на постепенное повышение точности отдельных моделей — чем больше людей полагаются на результаты работы ИИ при принятии важных решений, тем больше возможностей для того, чтобы незамеченная иллюзия нанесла реальный ущерб.
Что действительно уменьшает галлюцинации (и что не уменьшает)?
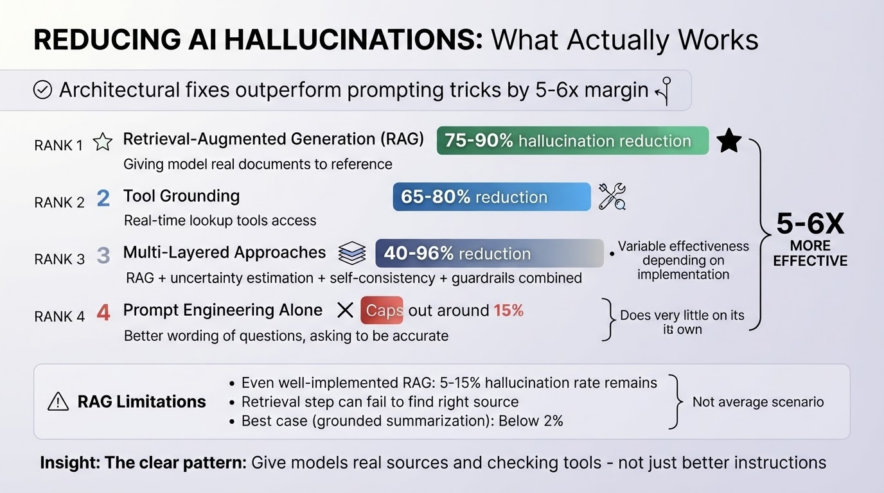
Именно эта часть данных действительно полезна для всех, кто внедряет ИИ в реальный рабочий процесс.
Методы, ранжированные по эффективности:
Техника | Уменьшение галлюцинаций |
Генерация с расширенным поиском (RAG) | 75-90% |
Привязка инструментария (предоставление модели доступа к инструментам поиска в реальном времени) | 65-80% |
Многоуровневые подходы (комбинация RAG + оценка неопределенности + самосогласованность + ограничительные условия) | 40-96% |
Достаточно было бы просто оперативного проектирования (более удачная формулировка вопроса). | Максимальный уровень составляет около 15%. |
Закономерность очевидна: архитектурные исправления — предоставление модели реальных документов для сравнения и инструментов для проверки ее работы — значительно превосходят методы напоминания, примерно в пять-шесть раз эффективнее. Простое более тщательное обращение к модели или указание ей «быть точной» само по себе мало что дает.
В чём RAG всё ещё отстаёт:
Даже хорошо реализованные системы RAG всё ещё приводят к галлюцинациям в 5-15% случаев, обычно когда на этапе поиска не удаётся найти нужный исходный документ. В задачах, требующих обоснованного суммирования, частота галлюцинаций может быть ниже 2%, но это наилучший сценарий, а не средний.
Как предприятия на самом деле выявляют эти ошибки
Метод обнаружения/смягчения последствий | Предприятие Принятие |
RAG как автоматизированная система смягчения последствий | 68% предприятий |
Процессы проверки с участием человека | 76% предприятий |
Специализированные API для проверки | Только 19% предприятий |
Системы обнаружения в реальном времени, отмечающие соответствующие ответы. | Примерно 20% ответов чат-бота следует помечать как потенциально галлюцинаторные. |
Наиболее показательным здесь является разрыв между внедрением RAG (68%) и внедрением специализированных инструментов проверки (19%). Большинство компаний полагаются на методы исправления ошибок на основе поиска информации и проверку человеком, а не на автоматизированные системы проверки фактов, специально разработанные для обнаружения ложных срабатываний — это означает, что значительная часть внедрения ИИ в предприятиях по-прежнему зависит от того, сможет ли человек обнаружить ошибку до того, как она вызовет проблему.
Заключение
История о фиктивных ошибках, которая встречается в результатах тестирования моделей (менее 1.5% ошибок), и история о фиктивных ошибках, выявляемая в реальных предметно-ориентированных тестах (до 88% в юридических исследованиях), описывают одни и те же модели, но практически совершенно разные реальности. Общие тесты измеряют, насколько хорошо модель обрабатывает простые, хорошо документированные факты; специализированные области показывают, как часто она фальсифицирует правдоподобно звучащие ответы, когда реальная информация неясна или отсутствует в обучающих данных. Хорошая новость в том, что этот разрыв устраним: генерация с использованием методов поиска и привязка инструментов снижают частоту фиктивных ошибок на 65-90%, значительно превосходя по эффективности подсказки. Менее утешительная новость заключается в том, что внедрение специализированных инструментов верификации в предприятиях по-прежнему составляет всего 19%, а это значит, что большинство организаций, внедряющих ИИ в ответственных областях, по-прежнему в значительной степени полагаются на людей, выявляющих ошибки, о которых модель не знает.
Часто задаваемые вопросы
В целом, по общим показателям, частота галлюцинаций снизилась примерно на 96% с 2021 года, что делает средние значения впечатляюще низкими. Однако в специализированных областях права и медицины частота галлюцинаций по-прежнему достигает 43-88%, а это значит, что эталонный показатель редко отражает реальные результаты.
Для проведения юридических исследований модель должна выдавать точные ссылки на судебные дела и решения, специфичные для конкретной юрисдикции, что гораздо сложнее, чем составление резюме документов или ответы на вопросы общего характера. Именно поэтому частота ошибок возрастает с примерно 6.4% при выполнении более простых юридических задач до 58-88% при тестировании моделей на конкретных, реальных запросах в области юридических исследований.
Грамотно реализованная система RAG может снизить частоту галлюцинаций на 75-90% за счет использования ИИ на основе проверенных исходных документов. Однако даже при эффективной реализации RAG галлюцинации все еще возникают в 5-15% случаев, как правило, когда на этапе поиска не удается обнаружить нужный материал.
Нет, одни лишь инженерные решения значительно менее эффективны, чем архитектурные решения, такие как RAG и заземление инструментов. Данные показывают, что подходы, основанные на заземлении, обеспечивают примерно в пять-шесть раз большее снижение частоты галлюцинаций по сравнению с использованием одних только инженерных решений.
Это небезопасно — частота галлюцинаций при проведении конкретных медицинских исследований колеблется от 43 до 88%, что слишком высоко, чтобы принимать какие-либо решения без проверки с помощью квалифицированного специалиста или первоисточника клинической информации. Результаты применения ИИ в медицине и юриспруденции лучше рассматривать как отправную точку для исследований, а не как окончательный ответ.