Группа волонтеров в Википедии создала общедоступное руководство, документирующее повторяющиеся закономерности в текстах, написанных искусственным интеллектом, предоставляя редакторам и читателям общий справочник для выявления скрытого контента, созданного ИИ.
Страница под названием «Признаки письма, созданного ИИ» поддерживается проектом WikiProject AI Cleanup и содержит около 15 000 слов, в которых каталогизируются привычки, наблюдаемые в тысячах черновиков, созданных ИИ.
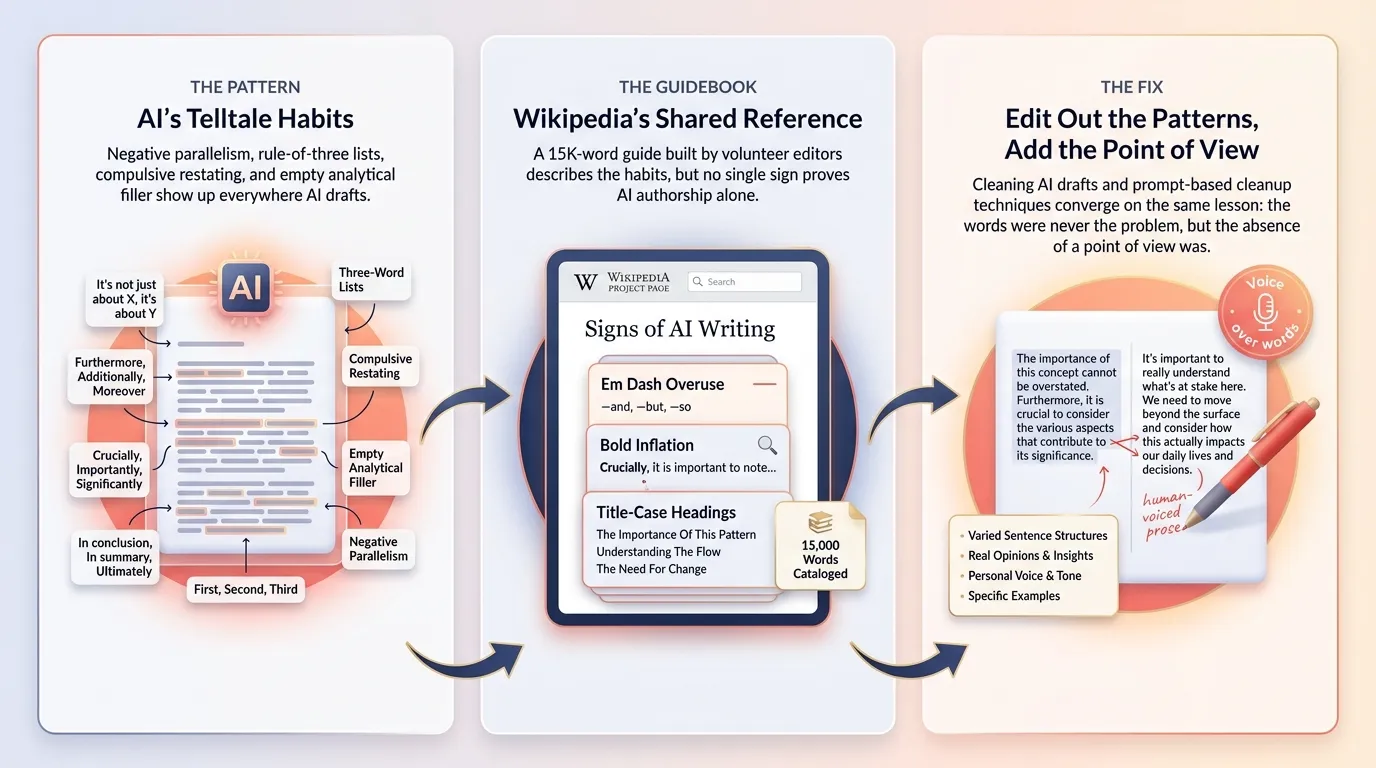
Данное руководство носит описательный характер, а не является сводом правил. Редакторы Википедии прямо заявляют, что ни один отдельный признак не доказывает авторство ИИ, поскольку языковые модели обучаются на человеческом тексте, и некоторые закономерности встречаются и в обычном человеческом тексте.
Ценность заключается в обнаружении нескольких знаков, расположенных рядом, а не только одной отмеченной фразы.
Повторяющиеся закономерности
Несколько характерных признаков повторяются снова и снова. Отрицательный параллелизм — один из самых распространенных: предложения, построенные по принципу «Дело не только в X, дело в Y», — структура с контрастом и переформулировкой, которая постоянно встречается в результатах работы ИИ и редко — в естественной речи.
Еще один признак обмана — списки, составленные по правилу трех: ИИ почти всегда выбирает тройки, такие как «инновационный, преобразующий и новаторский», при составлении любого списка.
К другим подобным моделям относятся навязчивое суммирование, когда ИИ пересказывает только что объясненное так, будто читатель не может запомнить основную мысль на протяжении трех абзацев, а также пустые аналитические метки, прикрепленные к очевидным фактам, например, фразы вроде «подчеркивая его долгосрочное влияние», которые не добавляют никакой реальной информации.
Редакционные замечания вроде «важно отметить» и оставшиеся фразы, используемые для обозначения сотрудничества, например, «дайте мне знать, если вам что-нибудь еще понадобится», дополняют список, наряду с чрезмерным использованием тире, избыточным выделением жирным шрифтом и непоследовательным написанием заголовков с учетом регистра.
Почему это важно для создателей контента
Это соответствует уже распространенным методам быстрой очистки черновиков, созданных с помощью ИИ, перед публикацией.
В одном из недавно опубликованных в интернете заданий модели предлагается проанализировать текст на предмет именно таких привычек, варьируя структуру предложений, заменяя жесткие формулировки и переписывая текст таким образом, чтобы отражались мнения и естественные изменения тона, а не довольствуясь тоном нейтрального наблюдателя, пытающегося угодить всем.
Это совпадение не случайно. Список Википедии и методы очистки текста на основе подсказок сходятся в одном и том же выводе: текст, созданный с помощью ИИ, становится пригодным для использования в тот момент, когда кто-то удаляет шаблоны, которые изначально делают его похожим на текст, созданный ИИ. Настоящая проблема никогда не заключалась в словах. Проблема заключалась в отсутствии точки зрения.
Быстрые ссылки: